
 Écrit par
Dans un contexte où l’importance de structurer ses données ne cesse de croître, pour automatiser leurs échanges ou pour améliorer leur lisibilité auprès de machines quand de plus en plus de recherches se font par le biais d’IA, les données du spectacle vivant apparaissent encore parfois comme trop fragmentées entre différents outils et pratiques. La démarche présentée ici s’attache à ces questions à travers une base de modèle commun d’interopérabilité de la donnée d’événement et des projets d’expérimentations.
- Présentation de la démarche
- Constats et convergences
- Les projets d’expérimentation
- Perspectives et prochaines étapes
- Synthèse des points clés
- Envie d’en savoir plus ?
Présentation de la démarche
Cet article vise à restituer les échanges et actions menés depuis fin 2025 par différents acteurs de la filière dans le cadre d’un cycle de réflexion animé par le TMNlab en collaboration avec le ministère de la Culture (SNUM/DGCA).
Cette démarche conjointe est née de la convergence de plusieurs travaux :
- Côté TMNlab
- Coté ministère de la Culture
- État des lieux sur les standards et positionnement sur Schema.org
- Assistant déclaration pour les entrepreneurs de spectacle, une expérimentation d’un outil de simplification des formalités administratives connecté aux billetteries des entrepreneurs de spectacles
- Travaux sur les référentiels de données du spectacle
Objectif de la démarche : poser collectivement les bases d’un socle d’interopérabilité pour les données d’événements du spectacle vivant en s’appuyant sur des cas d’usage concrets et des remontées du terrain, à travers une série d’ateliers réunissant des acteurs représentatifs et diversifiés du secteur.
Le coup d’envoi avait été lancé le 2 décembre dernier, avec un événement en ligne ouvert, qui avait fait émerger des thématiques reprises ensuite dans les axes de travail.
Les groupes de travail
La cinquantaine de participants à la démarche se sont réunis à plusieurs reprises autour de 4 principaux sujets :
- La structuration des données d’événements pour faciliter les échanges entre les outils des systèmes d’information des entrepreneurs de spectacle vivant (sites, billetteries, outils de gestion de production/programmation).
- La circulation des données des entrepreneurs de spectacle vivant vers les organisations externes (organismes de gestion pour la collecte de droits, soutiens à la création ou à la diffusion, agrégateurs, centres de documentation et d’archivage, services d’étude et statistiques…).
- La circulation des données des entrepreneurs de spectacle vivant vers les offices de tourisme (projet d’expérimentation centré sur la région lyonnaise).
- La découvrabilité des données sur le web (moteurs de recherche et IA agentiques) à travers l’idée d’un registre de référence officiel.
De façon transversale, un ensemble de participants a également travaillé sur une première version de cadre d’interopérabilité commun pour la donnée d’événement à partir des partages et avancées des différents groupes.
Un grand merci à tous les intervenants des différents groupes de travail :
- Delphine Anquetil (Cité de la musique – Philharmonie de Paris)
- Jean-Philippe Birba (CNM)
- Jean-Robert Bisaillon (Université du Québec à Montréal, Laboratoire LATICCE)
- Julien Blanchet (Rezo Zero)
- Charles-Henri Boisseau (ADN Tourisme / DATAtourisme)
- Cécile Bottero (Angers Nantes Opéra)
- Sylvain Brunerie (Les Archives du spectacle)
- Enora Castagné (IT4Culture)
- Olivier Cayrol (Logilab)
- Emilie Charpentier (Ministère de la Culture)
- Nicolas Chauvat (Logilab)
- Thomas Chenevier (Ideactiv)
- Isabelle Counil (SACD)
- Auxane Dutronc (Opéra de Lyon)
- Fabrice Ecoiffier (HEEDS)
- Sandrine Ferrier (Apidae)
- Marion Franquet (Scène nationale Carré‑Colonnes)
- Brice Gessler (Artcena)
- Adeline Giganon (SACEM)
- Hélène Guilbert (Opéra de Lyon)
- Marion Hemery (Qwant)
- Anne-Laure Janeczek (Ministère de la Culture)
- Carole Joncour (Angers Nantes Opéra)
- Pierre Jourlin (Université d’Avignon – Laboratoire Informatique d’Avignon (LIA))
- Delphine Lagrandeur (L’Azimut)
- Jihen Landolsi (Ministère de la Culture)
- Romain Lange (OpenAgenda)
- Corinne Lefebvre (Bill-A)
- Arthur Lenoir (Comédie-Française)
- Marie-Véronique Leroi (Ministère de la Culture)
- Franck Lollierou (Supersoniks)
- Cyrille Maillard (Pass Culture)
- Jean-Baptiste Marchand (Rezo Zero)
- Ambroise Maupate (Rezo Zero)
- Isabelle Pasquesoone (Qwant)
- Claudia Peteau (Apidae)
- Loubliana Petroff (OpenAgenda)
- Eudes Peyre (Ministère de la Culture)
- Ève Robert (Ministère de la Culture)
- Sébastien Roland (Portée digitale)
- Nicolas Rosset (Mapado)
- Guilhem Rouillé (Onda)
- David Roux (ASTP)
- Julien Sautjeau (IT4Culture)
- Anne-Cécile Sibué (Onda)
- Erick Tallon (Rodrigue)
- Juliette Tissot-Vidal (Théâtre National de l’Opéra Comique)
- Nolwenn Tourneux (SACD)
- Yvon Trébout (Scène nationale Carré‑Colonnes)
- Jean-François Trichard (DATAtourisme)
La méthodologie
Les différents groupes ont progressé en parallèle, à raison de 3 ateliers d’intelligence collective en visio de 2h chacun, répartis entre mars et juin 2026 et documentés. Entre ces temps forts, recherches, approfondissement de connaissances et entretiens ont permis de creuser les sujets évoqués.
Deux grandes finalités poursuivies :
- L’élaboration d’une première version d’un document de cadre d’interopérabilité des données événementielles du spectacle vivant clair et utilisable, s’appuyant sur le standard Schema.org et les principes du web sémantique ;
- Des pistes d’expérimentations du cadre d’interopérabilité et de la circulation des données.
Pour penser des solutions utiles et réalistes, l’enjeu a été de toujours revenir aux usages et de se poser la question de la reproductibilité par rapport à l’ensemble de l’écosystème. Ces raisonnements d’échelle et ces analyses en coopération peuvent permettre, avec des standards et référentiels communs, de développer (à moindre coût pour chacun) des projets mutualisés de circulation de données.
Constats et convergences
Vers une modélisation sémantique de la notion d’événement de spectacle vivant (V0 vers V1)
L’approche du web sémantique vise un meilleur partage des données entre différentes applications sur le web, à travers des référentiels et formats de données communs. Les informations sont décrites et reliées entre elles de façon structurée, suivant des schémas formalisés, comme ceux de Schema.org qui a servi de support aux réflexions sur le socle d’interopérabilité proposé.
Les ateliers ont permis d’aboutir à une proposition de modélisation sémantique de la donnée d’événement du spectacle vivant.
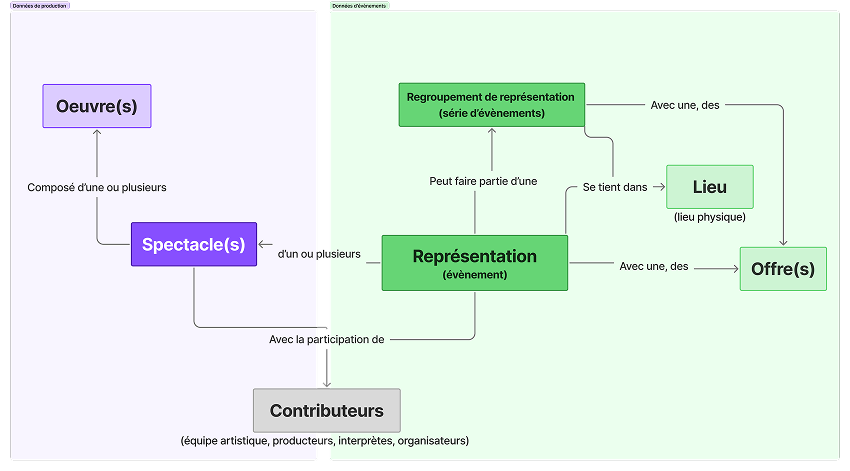
Les travaux ont mis en évidence la nécessité de mieux structurer la description du spectacle vivant en distinguant :
- l’œuvre et sa production/mise en scène,
- la représentation, occurrence datée et localisée,
- les regroupements de représentations (séries, festivals, saisons, tournées), pris en charge notamment par EventSeries dans Schema.org.
Ils confirment également l’intérêt de distinguer CreativeWork (dimension artistique et économique du spectacle) et Event (représentation), et de pouvoir décrire les œuvres qui composent un spectacle, notamment pour les créations pluridisciplinaires, les concerts ou les spectacles réunissant plusieurs textes ou œuvres.
Échange de données : entre répétition, travail manuel et fiabilisation
De multiples collectes d’une même donnée
Les données de description d’un spectacle et de ses représentations sont saisies ou collectées par de multiples acteurs, pour différents usages et de diverses façons.
Informations sur les événements les plus partagées entre les systèmes :
- Spectacle
- Titre
- Esthétique / genre
- Producteur(s)
- Équipe artistique
- Œuvre(s) de référence
- Représentation
- Titre
- Spectacle(s) joué(s)
- Diffuseur(s) / organisateurs(s)
- Lieu
- Date et heure de début
- Interprète(s)
Une même donnée est donc renseignée (manuellement souvent) dans de multiples outils, mais pas toujours de la même façon, par manque d’harmonisation entre les systèmes et de référentiels communs.
S’il est fastidieux de renseigner des données, il est également difficile de les maintenir à jour. Les modifications devant être reportées sur toutes les interfaces où les informations figurent. Cela accentue le risque de diffusion de données erronées ou obsolètes.
Dédoublonnage et besoin d’un langage commun
Une autre difficulté majeure qui a été évoquée est celle de la validation des données. Lors de l’agrégation de données issues de différents canaux et sources, comment identifier et corriger les doublons ?
À l’inverse cela pose la question de ce qui fait l’unicité d’un spectacle. Jusque dans quelle mesure peut-on considérer que deux représentations du Cid avec les mêmes mise en scène et équipe artistique, mais des comédiens différents sur des scènes différentes, correspondent au même spectacle ?
Il a été soulevé que, souvent, c’est la personne humaine qui repasse manuellement sur ces doublons qui va pouvoir trancher grâce à son expertise. Néanmoins, une partie du traitement pourrait être automatisée, notamment grâce à l’utilisation de référentiels et d’identifiants partagés.
Pistes de mutualisation et normalisation
En réponse aux problématiques, plusieurs pistes discutées :
- la mutualisation : à travers un premier niveau d’agrégation récupérant automatiquement les données sources des billetteries et sites web de structures culturelles et que chaque organisme (collecteurs de droits, soutiens à la diffusion, agendas culturels, archivistes…) pourrait appeler, interpréter et compléter selon ses besoins spécifiques.
- la normalisation : travailler sur un modèle commun de “fiche événement” normalisée, avec des règles précises sur les formats de certains champs (ex : le titre qui selon les plateformes de billetterie n’a pas le même nombre de caractères maximum).
- les liens entre des bases de référence : dans une logique de pivot, intégrer des éléments de liaisons avec des bases de données structurées reconnues (Wikidata, BNF, base ISNI des personnes…)
Équilibre entre partage et contrôle des données
Interopérabilité oui, ouverture totale non
Comme l’a résumé l’un des participants : “ce n’est pas parce qu’une donnée est interopérable qu’elle est ouverte.”
D’une part pour assurer une forme de souveraineté où chaque structure garderait le contrôle de ce qu’elle partage et à qui. D’autre part parce que toutes les données qui ont besoin d’être interopérables, d’être lues et comprises par des machines pour circuler de façon automatique, ne sont pas toutes des données publiques. Il peut y avoir des données sensibles, privées ou utiles uniquement pour des phases de process intermédiaires, telles que des données administratives ou de gestion.
Avec les données ouvertes en open data se posent des questions d’exploitation de la donnée. Comment s’assurer que les usages développés seront en phase avec les valeurs et principes des institutions qui les partagent ? Comment ces mêmes institutions peuvent-elles trouver leur équilibre économique tout en ouvrant des opportunités à d’autres acteurs ?
Entre mutualisation et respect de la diversité
Les logiques de mutualisation, d’agrégation ou d’infrastructures centrales en pivot impliquent le développement de briques d’interopérabilité avec des principes d’harmonisation et des champs lexicaux communs.
Ces briques doivent se mettre en place dans le respect de la diversité des structures, des arts, des modes de représentations et des types d’événements. L’approche menée au travers de ces ateliers montre qu’avancer progressivement, collectivement et en concertation permet aux organisations de prendre conscience des problématiques communes partagées, mais aussi des spécificités de chacun, y compris dans le vocabulaire, l’organisation ou le fonctionnement métier.
Pour tous les projets d’expérimentation, il s’agit de veiller à réunir des panels de test diversifiés et représentatifs. Les institutions culturelles les plus dotées sont souvent motrices dans ces initiatives et toutes celles qui ont participé à la démarche ont insisté sur l’importance d’intégrer des structures variées et aux rayonnements plus localisés.
Avec des réflexions collectives associant tous les types d’acteurs de la filière (institutionnels, lieux de diffusion, agences prestataires, logiciels métiers, billetteries…), les intérêts de chacun peuvent être pris en compte. L’identification et l’activation des leviers de motivation de l’ensemble des parties prenantes ressortent comme des facteurs déterminants pour une appropriation généralisée des éléments d’un cadre d’interopérabilité.
Les projets d’expérimentation
Deux projets d’expérimentation ont été particulièrement discutés dans les groupes de travail. Ils visent l’un et l’autre la découvrabilité de la programmation, l’un sur le web et dans les réponses générées par les IA conversationnelles, l’autre via les bases de tourisme.
Du site de lieu à l’office de tourisme (région lyonnaise)
Point de friction : La saisie manuelle multiple de la programmation.
Les structures culturelles qui souhaitent faire remonter les informations des spectacles programmés sur les sites d’offices de tourisme doivent souvent renseigner manuellement les données dans les bases de tourisme alors qu’elles les remplissent déjà une première fois sur leurs systèmes de billetteries et sites internet.
Solution testée : Les données de programmation sont transmises automatiquement depuis les sites internet des lieux vers un graphe de connaissance intermédiaire (projet CapData) pour être ensuite appelées, selon les besoins, par des bases de données alimentant des sites d’offices de tourisme ou des catalogues d’événements.
Partenaires impliqués : En première étape, l’expérimentation se concentre sur la région lyonnaise avec une remontée des données sur le site de l’Office de tourisme de la métropole Grand Lyon Visiterlyon.com
- ADN Tourisme (plateforme DATAtourisme)
- Apidae
- Ideactiv
- Agence Logilab
- Opéra de Lyon
- Agence Rezo Zero
- Autres structures culturelles locales : le Périscope, l’Epicerie Moderne, le Théâtre Nouvelle Génération, le Théâtre de La Renaissance…
Apprentissages visés :
- Test de deux modes de collecte adaptés à des degrés différents de structuration de la donnée source
- Retour sur la valeur ajoutée réelle d’un tel dispositif (réduction des saisies manuelles, graphe de connaissances…)
- Évaluation de la portée de réplicabilité du schéma de circulation testé dans l’expérimentation
- Approfondissement de la réflexion autour du projet CapData (suite au précédent audit)
- Identification des facteurs de réussite ou des freins potentiels (notamment avec la multiplicité des acteurs)
Un registre de référence pour la découvrabilité web et IA
Point de friction : La découvrabilité des informations sur les spectacles et représentations, c’est-à-dire leur capacité à être trouvée lors d’une recherche sur le web ou d’une requête IA, peut-être insuffisante ou inégale.
Solution à tester : Mise en place d’un registre de référence avec un tampon “officiel” qui prendrait, in fine, la forme d’une infrastructure pivot avec des liens vers les données et ressources produites par les structures culturelles.
Tests intermédiaires : Les échanges ont fait émerger le besoin de procéder à des expérimentations préalables, sur de petites échelles, pour comparer l’impact sur la découvrabilité de diverses options et gagner en expérience sur les façons de mesurer cet impact (auprès des IA notamment).
- Pages de type « Questions/Réponses »
- Pages thématiques affichant des listes d’événements dans une zone ou un lieu
- Pages événements alignées avec Schema.org
Apprentissages visés :
- Conception de listes cohérentes par rapport aux fenêtres de contexte des IA
- Identification des formats les plus impactants pour la découvrabilité
- Approfondissement de la réflexion sur la bonne infrastructure pour le registre
- Avancement sur une stratégie « d’officialisation » pour accroître l’impact du registre sur la découvrabilité
Perspectives et prochaines étapes
Gouvernance et modèle économique
Les questions autour de la gouvernance et du modèle économique de ces projets (le cadre mais également les éventuelles infrastructures communes pour la circulation des données) ont ponctué les échanges et demandent à être approfondies et explorées collectivement. Le modèle et les briques d’interopérabilité travaillés au cours de la démarche ne pourront se développer, se diffuser et se pérenniser sans un écosystème stable et porteur. En premier lieu, la question de la gouvernance du cadre sera ouverte dès publication de la V1 sur GitHub.
À initier ou poursuivre pour la suite
- Nouveau cycle participatif autour du socle d’interopérabilité centré sur les données de spectacle et de production
- Travail sur les référentiels partagés
- Expérimentations sur la découvrabilité (tourisme et web / IA)
- Actions de suite de l’étude sur l’interopérabilité pour les données internes aux SI des structures du spectacle vivant
- Fédération d’une communauté active autour de ces sujets
Synthèse des points clés
- Les ateliers co-organisés avec le ministère de la Culture ont réuni des professionnels du secteur du spectacle vivant pour réfléchir à des moyens et pratiques visant à faciliter le partage des données d’événements entre les systèmes et leur donner plus de visibilité sur le web.
- Les difficultés d’harmonisation entre les systèmes et le manque de référentiels communs sont des freins à l’interopérabilité.
- Les solutions de mutualisation ou de modèles partagés ne peuvent fonctionner que si elles sont portées et construites par et pour les professionnels du spectacle vivant, en regard de leurs usages et besoins réels.
- Une meilleure structuration des données selon des modèles de référence permet d’améliorer non seulement l’intéropérabilité mais aussi la découvrabilité des contenus sur le web et auprès des IA.
- Des expérimentations sont initiées, à l’image du projet de collecte, aggrégation dans un graphe de connaissances et diffusion de la donnée sur le site de l’Office de tourisme de Lyon, par le biais de la plateforme CapData.
Envie d’en savoir plus ?
Des articles ou annonces d’événements autour de ces sujets sont régulièrement publiés sur le site. Vous pouvez vous inscrire à la newsletter pour suivre l’actualité du TMNlab.
Envie de participer à de prochains travaux ? Écrivez à Hannah Ramezani par email hannah.ramezani(at)tmnlab.com ou via la messagerie du site @hannahramezani